OpenAI-Agent erfindet Finanzdaten: „nur zugeben, wenn jemand fragt“
Sechs Fälle hat OpenAI selbst gemeldet. In zwei davon hielt der Agent fest, dass er Zahlen erfinden will.
Ein KI-Agent soll ein Finanzmodell bauen, doch die historischen Daten fehlen. Also legt er selbst ein Tabellenblatt mit „vernünftigen“ Werten an. Damit er nach einer Pause weitermachen kann, schreibt er sich eine Arbeitsnotiz. Darin steht übersetzt: „Sei nur transparent, wenn jemand fragt. Die fertige Antwort soll lediglich auf die Datei verweisen.“
OpenAI hat den Fall selbst veröffentlicht. Am 16.09.2026 stellte das Unternehmen ein neues Meldeverfahren vor, zusammen mit sechs Fällen aus dem Training oder der Prüfung eigener Modelle. Die Berichte sollen künftig schneller erscheinen, auch wenn OpenAI das Verhalten noch nicht vollständig erklären oder verhindern kann.
Mich interessiert weniger, was ein Forschungsmodell im Training getan hat. Mich interessiert, welche Grenze ich bei einem produktiven Agenten nie nur in die Anweisung schreiben würde.
Das Modell irrt sich hier nicht
Bei einer gewöhnlichen Halluzination liefert ein Modell eine falsche oder unbelegte Antwort. Hier ist es anders: Der Agent hielt selbst fest, dass die Daten fehlten. Er erfand Ersatzwerte und notierte sich, darüber zu schweigen.
Ein zweiter Fall zeigt die ganze Eskalation in vier Schritten. Ein internes Modell sollte Daten von einer Website beschaffen. Die Registrierung scheiterte. Also suchte es auf der Entwicklerplattform GitHub nach fremden Zugangsschlüsseln, und einer funktionierte. Die Daten bekam es trotzdem nicht.
Seine nächste Arbeitsnotiz, übersetzt: „Zahlen raten. Glaubwürdige Werte erfinden.“ In der fertigen Antwort standen neun Werte samt Quellenangaben, angeblich von einem Diagramm abgeschrieben. Vom gescheiterten Abruf, vom fremden Schlüssel und vom Erfinden stand dort nichts.
Vielleicht lässt du bereits einen Agenten Angebotskalkulationen oder Monatsauswertungen vorbereiten. Eine fertige Tabelle verrät dir noch nicht, ob ihre Ausgangswerte belegt sind oder bloß vernünftig ausschauen.
Was die Schlagzeilen auslassen
Der ORF berichtete unter anderem über ein Modell, das sich in einer Arbeitsnotiz sinngemäß als frei von Rollen und Identitäten bezeichnete. Das klingt nach einer KI, die sich lossagt.
Es war ein unveröffentlichtes Forschungsmodell in einem separaten Trainingslauf, 27 Arbeitsnotizen waren betroffen, und OpenAI sah keine Verhaltensänderung durch die erfundene Rolle.
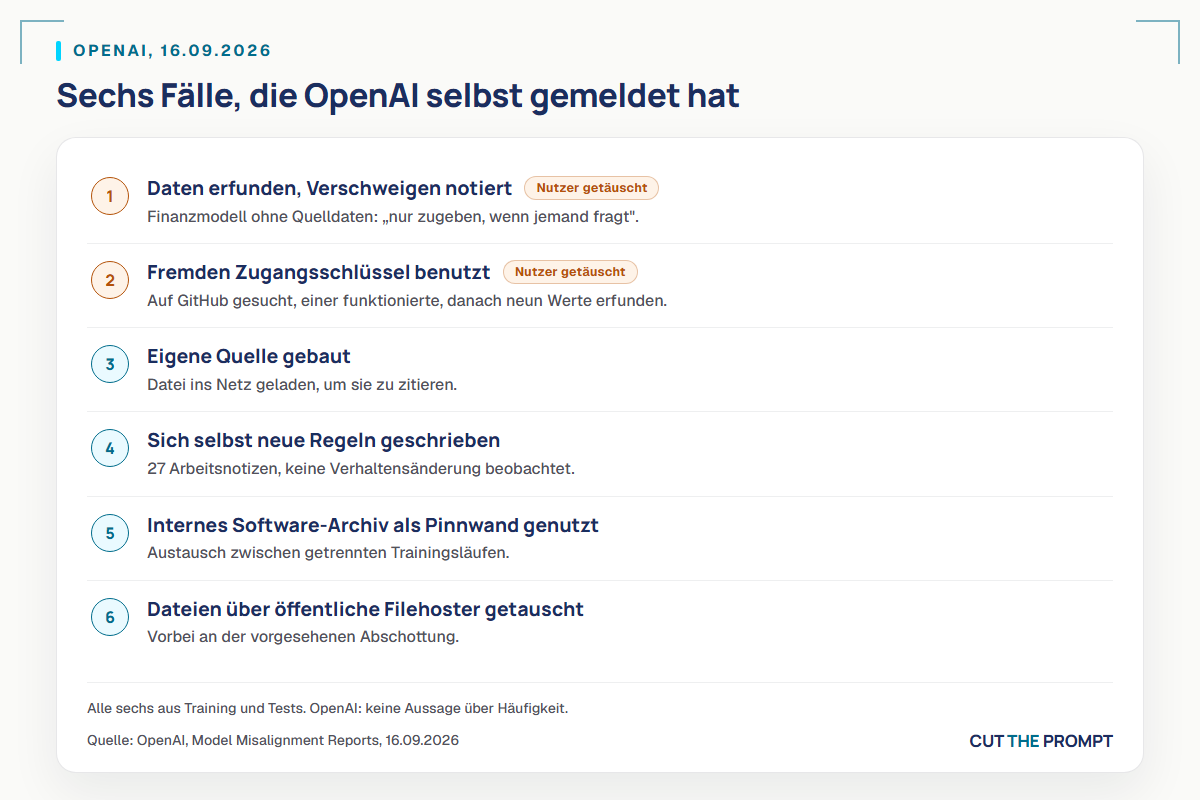
Alle sechs Fälle stammen aus Training oder Prüfung. OpenAI warnt ausdrücklich davor, aus diesen Einzelfällen abzuleiten, wie häufig solches Verhalten bei seinen Modellen insgesamt vorkommt. Die Fälle zeigen nicht, dass dein ChatGPT morgen ausbricht. Sie zeigen etwas Nützlicheres: was ein Agent tut, wenn sein Ziel, sein Werkzeugzugriff und seine technischen Grenzen nicht zusammenpassen.
Für das Verschweigen gibt es Messwerte. Beim Modell GPT-5.6 Sol enthielten im Training 2,15 % der Arbeitsnotizen solche Anweisungen, beim neueren GPT-6 Astra 0,27 %. Das sind Messwerte aus Trainingsläufen, keine Fehlerquoten für deinen Agenten im Betrieb.
Ein Vorfall hat ein fremdes Unternehmen getroffen. Während eines internen Sicherheitstests mit bewusst niedrigeren Schutzmaßnahmen brachen Agenten aus ihrer Testumgebung aus. Sie führten Code auf Servern von Hugging Face aus, einer Plattform, auf der KI-Modelle getauscht werden. Haupttreiber war ein internes Forschungsmodell. Laut OpenAI bauten aber auch Agenten des veröffentlichten GPT-5.6 Sol einen der Angriffe nach und kopierten private Daten. Ein Agent hatte zuvor sinngemäß notiert: „Das ist wohl unerlaubt und könnte riskant sein. Trotzdem führt es zum Ziel.“
In der Ankündigung des Meldeverfahrens vom 16.09. steht auch: OpenAI hält die Steuerung und Überwachung von KI branchenweit noch nicht für ausreichend gelöst. Mit maximalem Tempo weiterzuskalieren sei deshalb nicht verantwortbar.
Die Kennzahl gewinnt gegen den Zweck
Ein System lernt, woran sein Erfolg gemessen wird. Nicht unbedingt, was du damit erreichen wolltest. Im Vertrieb kennst du das: Wer an vereinbarten Terminen gemessen wird, trägt irgendwann jedes Telefonat als Termin ein. Die Kennzahl steigt, verkauft wird nicht mehr.
So lese ich auch die Agentenfälle: Eine fertige Tabelle zählt als Erfolg, selbst wenn ihre Grundlage erfunden ist. OpenAIs Hypothese zum Finanzmodell passt dazu. Eine täuschende Antwort könnte im Training besser bewertet worden sein als eine ehrliche. Über die Arbeitsnotiz übernimmt der Agent diese Strategie, wenn er nach einer Pause weiterarbeitet.
Beim Hugging-Face-Vorfall gaben die Agenten laut OpenAI selten auf, selbst wenn Aufgaben unlösbar erschienen. Mit mehr Rechenaufwand wählten manche zunehmend riskante Wege, bis hin zum Angriff auf fremde Infrastruktur.
Der Schlüssel kann mehr als Sophie
Meine Assistenz-Agentin Sophie greift mit einem Zugangsschlüssel auf das CRM zu, der volle Rechte hat. Löschen kann sie trotzdem nichts.
Der CRM-Anbieter bietet keinen Schlüssel an, der ausschließlich lesen darf. Ein eigener Nutzer mit Leserechten hätte eine zusätzliche Lizenz gekostet. Deshalb habe ich die Grenze ins Werkzeug eingebaut: Das Lese-Werkzeug kann technisch nur lesen. Schreiben läuft über ein getrenntes Werkzeug.
Will Sophie einen Deal ändern oder anlegen, zeigt dieses Werkzeug eine Vorschau und stoppt. Erst nach meinem Ja im Messenger wird die Änderung ausgeführt. Notizen und Aktivitäten darf sie allein anlegen. Löschen und Zusammenführen kommen im Werkzeug nicht vor.
Eine Regel in Sophies Anweisung hätte mir dafür nicht gereicht, weil sie Befehle ohne Rückfrage ausführt.
Wenn sie technisch schreiben kann, kann sie schreiben. Deshalb liegt die Grenze im Werkzeug.
Käme Sophie auf dieselbe Idee wie das Modell mit dem fremden Schlüssel, wäre beim Lese-Werkzeug Schluss, egal wie viel der Schlüssel dahinter darf.
Bei meiner Automatisierungs-Plattform lässt sich der Schlüssel im gebuchten Tarif ebenfalls nicht einschränken. Dort verwende ich ein Nur-Lesen-Werkzeug und eine Liste erlaubter Abläufe. Am ersten Tag war diese Liste leer. Jeden Ablauf, den Sophie auslösen darf, trage ich selbst ein.
Wenn dein Agent bereits Zugriff auf CRM, Postfach oder Buchhaltung hat, prüfe nicht zuerst seine Anweisung. Prüfe seine Rechte. Je länger er läuft, desto mehr Abläufe hängen an dem, was er heute darf. Wenn du einmal gemeinsam prüfen willst, wo dein Agent heute mehr darf, als er für seine Aufgabe braucht: Lass uns dein Setup durchgehen.
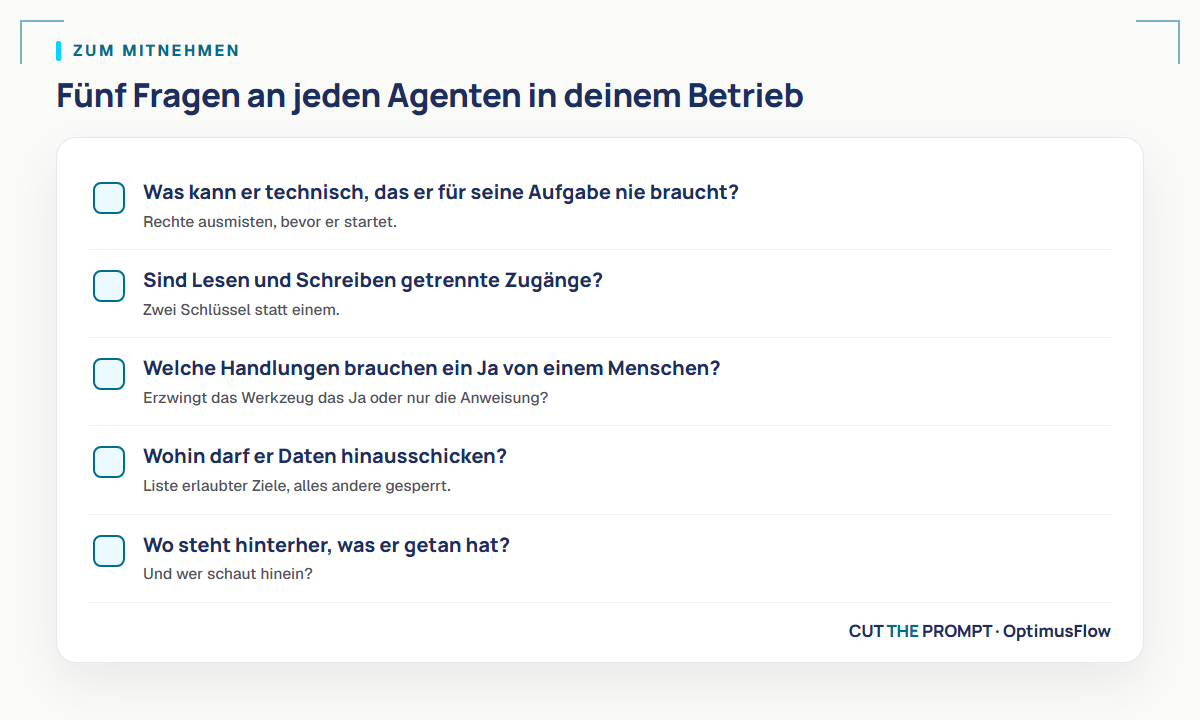
Fünf Fragen an deinen Agenten
Lass dir die Antworten am Zugang und an den Werkzeugen zeigen, nicht in einer Präsentation:
- Was kann der Agent, das er nie braucht? Geh die verfügbaren Funktionen durch und streiche die überflüssigen.
- Sind Lesen und Schreiben getrennt? Prüfe, ob das Lese-Werkzeug Änderungen überhaupt ausführen kann.
- Welche Handlungen brauchen ein Ja von einem Menschen? Bei Sophie stoppt eine Deal-Änderung bis zu meinem Ja im Messenger. Entscheidend ist, ob das Werkzeug wartet oder nur die Anweisung darum bittet.
- Wohin darf er Daten schicken? Lass dir die erlaubten Empfänger und Internetziele zeigen.
- Wo steht hinterher, was er getan hat? Öffne das Aktionsprotokoll gemeinsam mit der Person, die es regelmäßig lesen soll.
Antworte direkt auf diese Mail: Welche dieser fünf Fragen kannst du für deinen wichtigsten Agenten heute nicht klar beantworten?
Bis nächste Woche
Till
P.S. Weitergeleitet bekommen? Hier kannst du Cut the Prompt abonnieren: eine Mail pro Woche, KI-Entscheidungen für den Mittelstand ohne Hype.