GPT-6 und Fable 5.1: Deine Prompts liegen 30 Tage beim Anbieter
Zero Data Retention gibt es nur auf Antrag. Welche Teile deines Dokumentenworkflows trotzdem speichern.
Null Tage sind möglich, aber nicht per Schalter. OpenAI will vorher eine Freigabe, in der EU dazu 10 Prozent Aufschlag. Anthropic gibt sie für Fable 5.1 gar nicht her. In den Ankündigungen dieser Woche steht davon kein Wort.
Zwei Modelle, zwei Kleingedruckte
Am 1. September erschien Claude Fable 5.1. Die Ankündigung handelt von Fähigkeiten. Für einen Betrieb mit Kundendaten steht der wichtigere Teil in den Datenhaltungsregeln: Fable 5.1 ist bei Anthropic ein „Covered Model“. Zero Data Retention gibt es dafür nicht automatisch.
Am 3. September folgte GPT-6 Astra. Zuerst für Unternehmen mit Trusted Access, danach für API, Plus, Pro, Business und Enterprise. Astra steht in OpenAIs Endpunkttabelle für Chat Completions, Responses, Batches und mehrere Regionen. Das Modell kann also unter ZDR laufen. Ob dein Workflow das kann, entscheidet jeder einzelne Endpunkt.
Die beiden Modelle sind nur der Anlass. Die Entscheidung fällt in den Datenhaltungsregeln.
OpenAI: Null Tage brauchen eine Freigabe
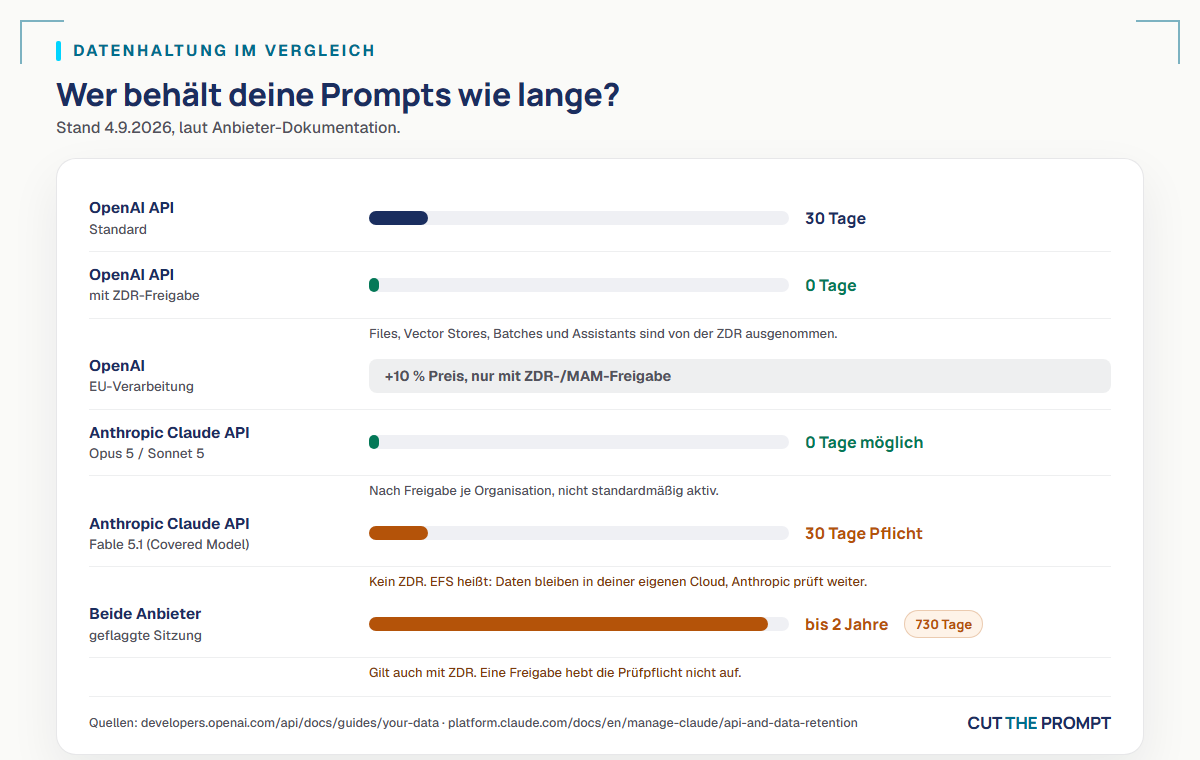
Bei der OpenAI API landen Prompts und Antworten standardmäßig bis zu 30 Tage in den Protokollen zur Missbrauchserkennung. Länger nur, wenn ein Gesetz es verlangt.
Zero Data Retention, kurz ZDR, gibt es nur für berechtigte Kunden. OpenAI genehmigt den Antrag vorab und verlangt Zusatzvereinbarungen, außerhalb der USA zusätzlich ein Modified-Retention-Amendment. Der Weg führt über den Vertrieb.
ZDR-fähig sind Chat Completions, Responses, Images, Embeddings, Audio, Completions, Realtime und Moderations. Nicht ZDR-fähig: Conversations, ChatKit Threads, Assistants, Files, Vector Stores, Batches, Fine Tuning, Evals und Videos.
Genau dort steckt das Problem für jeden Dokumentenworkflow. Eine Datei wird hochgeladen, in einem Vector Store durchsuchbar gemacht und später gesammelt verarbeitet. Der Modellaufruf kann unter ZDR fallen. Die Bausteine davor und danach tun es nicht.
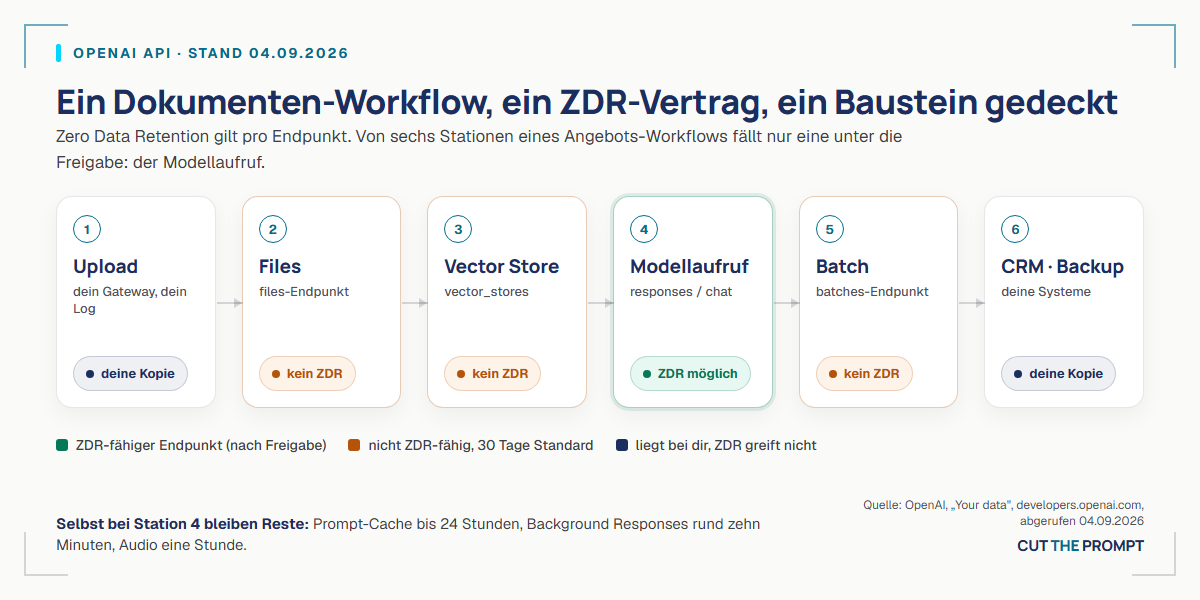
Selbst mit genehmigtem ZDR bleiben Ausnahmen. Background Responses liegen ungefähr zehn Minuten auf einem Datenträger. Bei Audioausgaben bleibt der Sitzungszustand eine Stunde erhalten. Der verschlüsselte Prompt Cache kann bis zu 24 Stunden auf lokalen GPUs bleiben. Bei Verdacht auf Missbrauchsdarstellungen von Kindern speichert OpenAI Bilder trotzdem.
Die EU-Verarbeitung über eu.api.openai.com setzt eine ZDR- oder Modified-Abuse-Monitoring-Freigabe voraus. Für berechtigte Modelle kostet sie 10 Prozent mehr. Das am 19. August vorgestellte Private Safety Processing war am 4. September noch eine Vorschau: Whitepaper angekündigt, Produkt nicht fertig.
Für dich heißt das: Ein ZDR-Vertrag schützt deinen Dokumentenworkflow nur, wenn jeder verwendete Endpunkt ZDR unterstützt.
Anthropic: Das stärkste Modell darf nicht alles sehen
Anthropic speichert API-Prompts und Antworten standardmäßig nicht. Die Ausnahme sind die Covered Models Fable 5.1, Mythos 5.1, Fable 5 und Mythos 5. Für sie gilt: mindestens 30 Tage Speicherung, verpflichtend. Danach werden die Daten automatisch gelöscht, sofern keine Sicherheitsprüfung oder gesetzliche Pflicht eine längere Aufbewahrung verlangt.
Anthropic begründet das wörtlich so: „some forms of misuse only become detectable across many requests“. Frei übersetzt: Manche Formen von Missbrauch erkennt man erst über viele Anfragen hinweg.
Als befristete Option gibt es Enterprise Frontier Safeguards. Die Überwachungsdaten liegen dann in einer Cloud, die du kontrollierst. Anthropics Sicherheitssysteme lesen trotzdem mit. Du bestimmst den Speicherort, mehr nicht. ZDR ist das keines.
Bei Sitzungen, die ein Sicherheitsfilter markiert hat, kann Anthropic Ein- und Ausgaben bis zu zwei Jahre aufbewahren. Das gilt auch mit ZDR. Opus 5 und Sonnet 5 sind keine Covered Models und können nach Freigabe mit ZDR laufen. Eine Organisation mit ZDR darf Covered Models nur in einem eigenen Arbeitsbereich mit eingeschalteter 30-Tage-Speicherung verwenden.
Code Execution und Programmatic Tool Calling fallen ebenfalls aus ZDR, weil Containerdaten bis zu 30 Tage gespeichert werden können. Eine direkte EU-Region bietet Anthropic nicht an. Über Amazon Bedrock EU oder Google Vertex EU bleiben gespeicherte Daten in der Umgebung des jeweiligen Cloud-Anbieters.
Für dich heißt das: Das leistungsstärkste Modell ist nicht automatisch das Modell, das deine Kundendaten sehen darf.
Warum ZDR kein DSGVO-Freibrief ist
ZDR ändert, was der Modellanbieter speichert. Es ersetzt weder die Rechtsgrundlage noch den Auftragsverarbeitungsvertrag nach Artikel 28. Übermittlungsmechanismus, Datenschutz-Folgenabschätzung, Löschkonzept und Betroffenenrechte bleiben Pflicht. Den Verarbeitungsort ändert ZDR auch nicht. Ein Direktvertrag mit einem US-Anbieter bleibt eine Verarbeitung in den USA.
Nimm einen Angebotsworkflow. Ein Kunde lädt einen Vertrag hoch. Dein API-Gateway protokolliert Dateiname und Kundennummer, bis du das Log selbst löschst. Die Datei landet beim Anbieter im Files-Endpunkt und wird für die Suche in einen Vector Store geschrieben. Beide Bausteine fallen aus ZDR. Erst der Modellaufruf über den Responses-Endpunkt kann unter die Freigabe fallen.
Danach speichert dein CRM das Angebot. Der Error Tracker übernimmt bei einem Fehler Teile der Eingabe. Das Backup kopiert den Datensatz erneut. „Zero“ beim Modellanbieter, „bis zur nächsten Löschung“ in deinen eigenen Systemen. Beides gleichzeitig.
Für dich heißt das: Prüfe den ganzen Weg vom Dateiupload bis zum Backup. Das Modell ist darauf nur eine Station.
Wenn du wissen willst, wo auf diesem Weg in deinem wichtigsten Workflow Kopien entstehen, gehen wir genau diese Kette gemeinsam durch: Jetzt unverbindliches Erstgespräch anfragen!
Was ich nach Datenklasse entscheide
Ich lege bei Kunden drei Stufen fest.
Bei Berufsgeheimnissen, besonderen Kategorien personenbezogener Daten und regulierten Personendaten bleibt die Verarbeitung in Europa. Dafür gibt es mehrere Wege: ein EU-gehostetes Modell über eine Plattform wie Langdock (Azure-Server in der EU, kein Training mit Kundendaten, Auftragsverarbeitungsvertrag vom Plattformanbieter), eine EU-Region über Amazon Bedrock oder Google Vertex, oder ein Anbieter mit Sitz in der EU. Ein direkter Vertrag mit einem US-Anbieter gehört nicht dazu. Welcher Weg passt, hängt vom Workflow und von den Cloud-Verträgen ab, die der Betrieb schon hat.
Für gewöhnliche Geschäftsdaten wie Kundennamen, E-Mails und Verträge braucht es einen Direktvertrag mit Auftragsverarbeitungsvereinbarung, ZDR und ein Modell, das ZDR überhaupt darf.
Bei internen Daten ohne Personenbezug reichen die Standardbedingungen.
Lokale Modelle empfehle ich nicht als Datenschutz-Allheilmittel. Sie streichen einen Punkt von der Prüfliste und machen Betrieb und IT-Sicherheit schwerer. Das neue Spitzenmodell landet bei mir auch nicht automatisch im Kundenworkflow. Ich prüfe Modelle an den Aufgaben, die sie später erledigen sollen. Danach verwende ich eine feste Modell-ID und keinen „latest“-Alias.
Den CLOUD Act nenne ich beim Kunden ein akzeptables Restrisiko. Gelöst nenne ich ihn nie.
Der Datenhaltungs-Steckbrief
Zu jedem produktiven Workflow gehört ein Datenhaltungs-Steckbrief mit Modell-ID, Speicherfrist beim Anbieter, genutzten Endpunkten samt ZDR-Ausnahmen, Verarbeitungsregion und AVV/DPF-Stand.
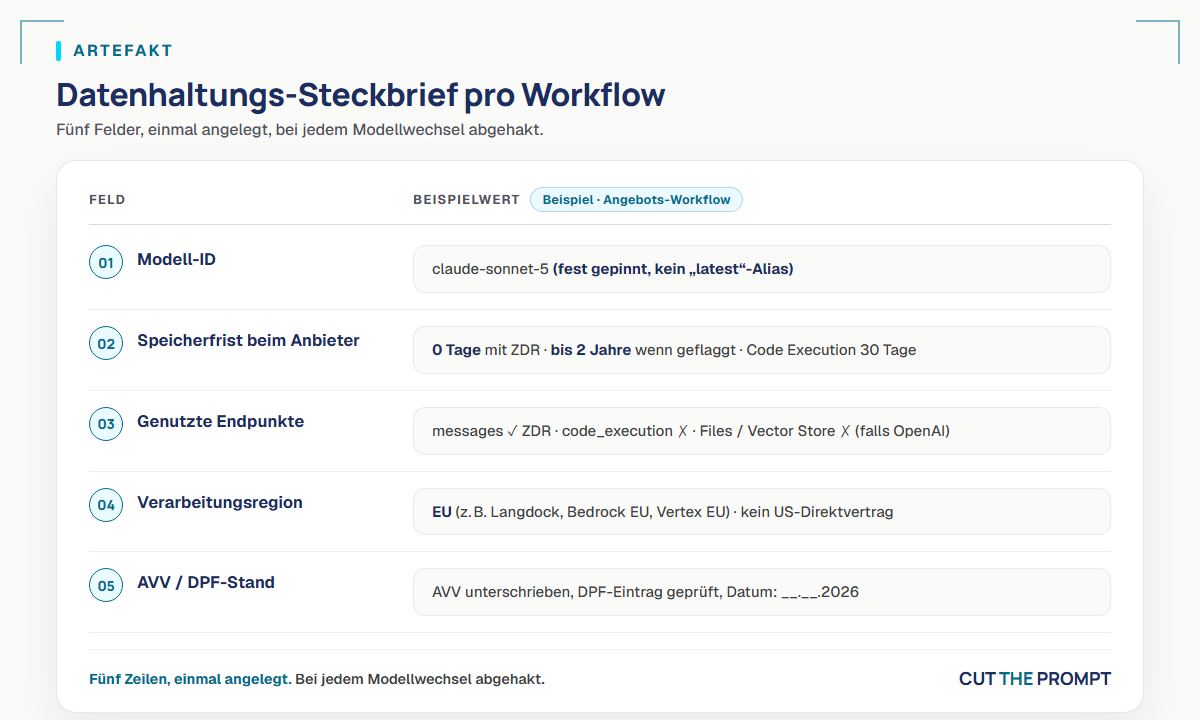
Trag die fünf Zeilen heute für deinen Workflow mit Kundenkontakt ein. Wenn du bei der dritten Zeile erst nachsehen musst, welche Endpunkte dein Tool benutzt, weißt du auch nicht, wo die Kopien liegen.
Bis nächste Woche
Till
P.S. Wenn dein Workflow noch keinen Datenhaltungs-Steckbrief hat: Jetzt unverbindliches Erstgespräch anfragen!